Teksty z ChatGPT, Claude’a i Gemini mają znak wodny. Jak działa po polsku i kto go sprawdzi
Wklejasz do CMS-a tekst z ChatGPT, Claude’a albo Gemini? Od 2 sierpnia 2026 r. taki tekst może nieść podpis, którego nie widać. To wzorzec statystyczny w doborze słów i odczyta go wyłącznie ten, kto ma klucz. Stoi za tym art. 50 AI Act: dostawcy AI muszą oznaczać generowane treści tak, żeby dało się je rozpoznać maszynowo.
Anthropic, OpenAI i Google wykonali ten obowiązek każdy po swojemu. Jeśli wydajesz serwis, prowadzisz sklep albo generujesz teksty w firmie, te różnice mają praktyczne skutki, np. dla tego, czy musisz oznaczać artykuły i czy wynik detektora cokolwiek dowodzi. Przeczytałem dokumentację trzech firm, rozporządzenie ze zmianami z lipca 2026 r., kodeks praktyk i wytyczne Komisji Europejskiej, a dwie rzeczy o polskim tekście policzyłem sam.
Najważniejsze w skrócie
- Obowiązek dostawców: od 2 sierpnia 2026 r. art. 50 ust. 2 AI Act wymaga, żeby tekst z AI był oznaczony w formacie do odczytu maszynowego. Systemy obecne na rynku wcześniej mają czas do 2 grudnia 2026 r.
- Claude: Anthropic znakuje teksty na całym świecie, bo nie umie jeszcze ograniczyć znaku do regionu. Znak dostają też tłumaczenia zrobione przez Claude’a.
- ChatGPT: OpenAI wprowadza znak w ChatGPT i Codexie tylko w UE. W API to opcja, którą klient włącza sam.
- Gemini: Google deklaruje znakowanie tekstów z aplikacji Gemini technologią SynthID. Dla API jego dokumentacja tego nie potwierdza.
- Kruchość: w teście OpenAI zamiana 25% słów na synonimy obniżyła wykrywalność znaku z ok. 92% do 17%.
- Polski tekst: w teście OpenAI na 24 językach UE znak wykryto w ok. 55% polskich tekstów, a po wzmocnieniu sygnału w ok. 64%, wobec ok. 68% dla angielskiego. To mój odczyt z wykresu OpenAI.
- Detektory: żaden z trzech dostawców nie udostępnia publicznie detektora znaku w tekście. Brak znaku nie dowodzi, że pisał człowiek.
- Obowiązek po Twojej stronie: tekst z AI o sprawach interesu publicznego trzeba oznaczyć, chyba że przeszedł weryfikację człowieka lub kontrolę redakcyjną, a ktoś ponosi za niego odpowiedzialność redakcyjną (art. 50 ust. 4).
Co wymaga AI Act: dostawca znakuje, wydawca ujawnia
Art. 50 AI Act dzieli obowiązki między dostawców, czyli firmy, które dostarczają system AI, i podmioty stosujące, czyli każdego, kto używa takiego systemu zawodowo. Znakowanie to obowiązek dostawców. Ujawnianie, że tekst powstał z AI, w części przypadków spada na Ciebie.
Dostawcy: znak, który odczyta maszyna
Obowiązek dostawców opisuje art. 50 ust. 2:
Dostawcy systemów AI, w tym systemów AI ogólnego zastosowania, generujących treści w postaci syntetycznych dźwięków, obrazów, wideo lub tekstu, zapewniają, aby wyniki systemu AI zostały oznakowane w formacie nadającym się do odczytu maszynowego i były wykrywalne jako sztucznie wygenerowane lub zmanipulowane.
Przepis nie mówi, jak to zrobić. Rozwiązanie ma być skuteczne i odporne, ale tylko „w zakresie, w jakim jest to technicznie wykonalne”, a przy tekście to zastrzeżenie waży dużo. Obowiązek nie obejmuje systemów, które jedynie pomagają w standardowej edycji.
Ty: ujawnienie przy tekstach o sprawach publicznych
Drugi obowiązek, z art. 50 ust. 4, dotyczy podmiotów stosujących:
Podmioty stosujące system AI, który generuje tekst publikowany w celu informowania społeczeństwa o sprawach leżących w interesie publicznym lub manipuluje takim tekstem, ujawniają, że tekst został sztucznie wygenerowany lub zmanipulowany.
Ujawniać nie trzeba, jeśli tekst przeszedł weryfikację człowieka lub kontrolę redakcyjną i ktoś ponosi za niego odpowiedzialność redakcyjną.
Kodeks praktyk: jak znakować tekst
Jak spełnić ust. 2, opisuje kodeks praktyk dotyczący przejrzystości treści generowanych przez AI. Wersja końcowa jest z 10 czerwca 2026 r., a 8 lipca Komisja uznała go za adekwatny. Jest dobrowolny i, jak zastrzega Komisja, jego przestrzeganie nie jest rozstrzygającym dowodem zgodności z prawem. Dla tekstu ustala takie zasady:
- Tekst swobodny, np. odpowiedź w czacie albo tekst wyświetlany na stronie, nie uniesie metadanych, więc wystarczy sam znak wodny.
- Tekst w pliku, np. w PDF, dokumencie Worda albo pliku HTML, dostaje dwie warstwy: podpisane metadane i znak wodny.
- Tekst krótszy niż 200 tokenów nie musi mieć znaku, bo przy tej długości znak nie działa wiarygodnie. Po polsku to ok. 94 słowa.
Terminy, nadzór i kary
Art. 50 stosuje się od 2 sierpnia 2026 r. Rozporządzenie 2026/1744, tzw. omnibus cyfrowy dla AI, dało systemom obecnym na rynku przed tą datą czas na znakowanie do 2 grudnia 2026 r. Projekt Komisji z listopada 2025 r. proponował 2 lutego 2027 r., więc jeśli trafisz na tę datę, czytasz nieaktualny tekst. Obowiązek z ust. 4 okresu przejściowego nie dostał.
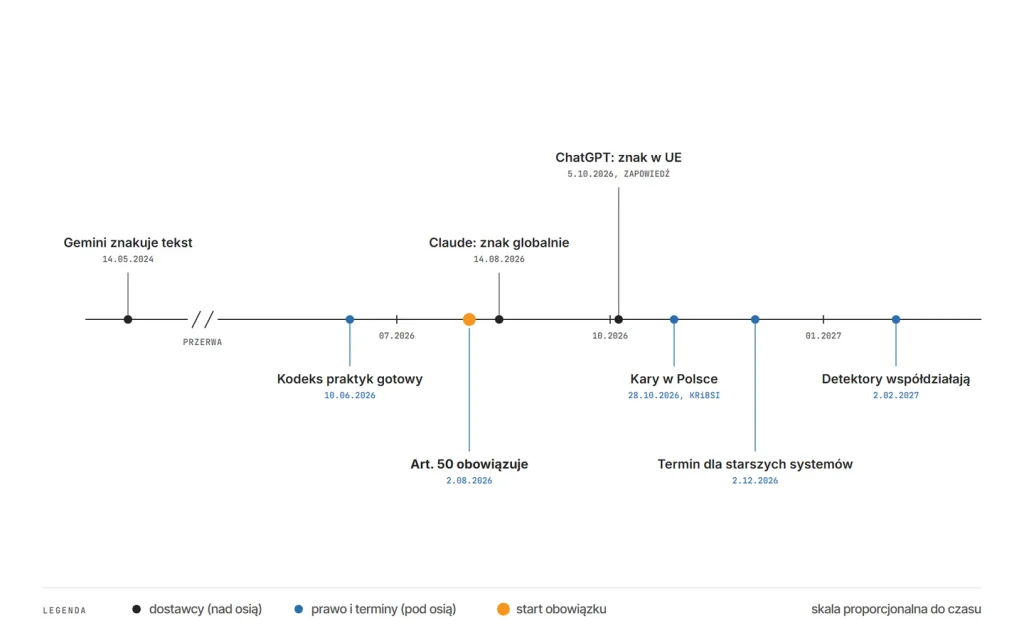
Skala proporcjonalna do czasu, z przerwą między 2024 a 2026 r. Stan na 19.10.2026.
Omnibus przesunął też nadzór. Znakowanie w systemach, w których model i aplikację robi ten sam dostawca, a tak jest w ChatGPT, Claude i Gemini, nadzoruje wyłącznie Urząd ds. AI (AI Office) w Komisji Europejskiej. Nad firmami, które z tych systemów korzystają, nadzór sprawują organy krajowe. W Polsce to Komisja Rozwoju i Bezpieczeństwa Sztucznej Inteligencji z ustawy z 3 lipca 2026 r., której przepisy o kontroli i karach zaczynają obowiązywać 28 października 2026 r. Za naruszenie art. 50 grozi do 15 mln euro albo 3% rocznego światowego obrotu, zależnie od tego, która kwota jest wyższa. Dla małych i średnich firm liczy się kwota niższa.
Jak działa znak wodny w tekście i czym nie jest
Model językowy pisze tekst po tokenie, czyli kawałku słowa. Przy każdym kroku ma kilku podobnie dobrych kandydatów i wybiera między nimi losowo. Znak wodny podmienia to losowanie: o wyborze decyduje tajny klucz razem z kilkoma poprzednimi tokenami. Z zewnątrz każdy wybór dalej wygląda na przypadkowy, ale ten, kto zna klucz, sprawdza, czy wybory w tekście pokrywają się z jego wzorcem częściej, niż wynikałoby z przypadku. Tak działa SynthID-Text, opisany przez Google DeepMind w Nature, na którym oparł się Anthropic, i na tej samej zasadzie textGrain od OpenAI.
Znak siedzi w samym doborze słów, więc w tekście nie ma ukrytych znaków ani dodatkowych spacji. Potrzebuje długości i swobody: w krótkim fragmencie, wyniku działania, danych, cytacie czy kodzie jest słaby, stąd próg 200 tokenów w kodeksie praktyk. Jakości tekstu nie psuje. W eksperymencie z Nature Google porównał oceny ok. 20 mln odpowiedzi Gemini ze znakiem i bez i nie znalazł istotnych statystycznie różnic, a niezależny test z września 2026 r. na otwartej implementacji SynthID-Text doszedł do podobnego wniosku.
Metadane to osobny mechanizm. Content Credentials w standardzie C2PA to podpisana informacja dołączona do pliku: Claude dołącza je do generowanych plików PNG, JPG i SVG, OpenAI do obrazów. Metadane giną przy zrzucie ekranu albo konwersji pliku, a tekst wklejony do CMS-a w ogóle ich nie niesie, więc w tekście jedyną warstwą jest znak wodny. Znak nie jest też detektorem AI, bo popularne detektory nie mają klucza żadnego dostawcy i zgadują po stylu. Nie zawiera też danych o użytkowniku, koncie ani rozmowie.
Trzech dostawców, trzy podejścia
Wszyscy trzej podpisali kodeks praktyk i znakują tekst w doborze słów. Różnią się zasięgiem, tym, czy klient ma wybór, i tym, kto może znak sprawdzić. Stan na 19 października 2026 r.:
| Anthropic (Claude) | OpenAI (ChatGPT, Codex, API) | Google (Gemini) | |
|---|---|---|---|
| Gdzie znakuje tekst | wszędzie: aplikacje, API, Claude Code, chmury partnerów; cały świat | ChatGPT i Codex tylko w UE; API na całym świecie, jeśli klient włączy | aplikacja i wersja webowa Gemini, bez ograniczenia do UE; API wg forum Google |
| Od kiedy | modele wydane od 2.08.2026 i część starszych; pozostałe dochodzą | ogłoszenie 5.10.2026, w UE „w najbliższych tygodniach” | od maja 2024 r. |
| Metoda | wersja SynthID-Text od Google DeepMind | własna: textGrain | SynthID-Text (open source od 10.2024) |
| Wyłączenie | dokumentacja nie przewiduje | w ChatGPT dokumentacja nie przewiduje; w API domyślnie wyłączony | dokumentacja nie mówi |
| Kto sprawdzi tekst | testowe API: regulatorzy, media, fact-checkerzy, badacze, edukacja, firmy z obowiązkami z AI Act | zatwierdzeni badacze i instytucje akademickie | nikt: SynthID Detector nie obsługuje tekstu |
| Pliki | C2PA w PNG, JPG, SVG | C2PA i SynthID w obrazach, SynthID w audio | C2PA i SynthID w obrazach, wideo, audio |
Anthropic: wszędzie i dla każdego klienta
Anthropic ogłosił znakowanie 14 sierpnia 2026 r. i poszedł najszerzej, bo, jak pisze, nie ma jeszcze trwałego sposobu, żeby ograniczyć znak do regionu. Metoda to wersja SynthID-Text z własnym kluczem, więc detektor Anthropic nie powie nic o tekście z innego modelu. Według centrum pomocy Claude znak mają modele wydane od 2 sierpnia i część starszych, np. Opus 4.8. Sonnet 4.6 czy Opus 4.7 jeszcze go nie mają, ale prawo daje na to czas do 2 grudnia.
OpenAI: tylko UE, a w API na życzenie
OpenAI przedstawiło swoje podejście 5 października 2026 r. i jest najostrożniejsze. Według firmy textGrain wypadł w jej testach co najmniej tak dobrze jak SynthID. Z programu dostępu do detektora OpenAI wprost wyklucza zastosowania biznesowe i sprawdzanie prac studentów. Start w ChatGPT zapowiedziało na „najbliższe tygodnie”, a centrum pomocy od ok. 12 października opisuje znak w UE w czasie teraźniejszym.
Google: autor metody, najmniej informacji
Google znakuje teksty z aplikacji i wersji webowej Gemini od maja 2024 r., na długo przed AI Act. Implementację SynthID-Text udostępnił jako open source w dniu publikacji w Nature, z zastrzeżeniem, że nie jest przeznaczona do zastosowań produkcyjnych. Kluczy Gemini nie udostępnił. O API dokumentacja milczy, a jedyne potwierdzenie to wpis na forum deweloperów z 19 sierpnia 2026 r., z konta oznaczonego jako Google, który prostował wcześniejszą odpowiedź, że znaku tam nie ma. SynthID Detector, otwarty dla wszystkich 7 października 2026 r., sprawdza obrazy, wideo i audio, ale nie tekst.
Jak kruchy jest znak: liczby dostawców i niezależne testy
Wszyscy trzej dostawcy piszą wprost, że znak nie jest pewny. Najwięcej liczb podało OpenAI. Dotyczą odpowiedzi po angielsku i progu, przy którym detektor myli się na 1% tekstów bez znaku:
| Warunki testu OpenAI | Wykrywalność znaku |
|---|---|
| fragment 200 tokenów, tematy z psychologii | ok. 80% |
| fragment 400 tokenów, tematy z psychologii | ok. 95% |
| tematy z matematyki | „znacznie niższa”, bez liczby |
| fragment 400 tokenów, bez edycji | ok. 92% |
| 10% słów zamienionych na synonimy | ok. 66% |
| 25% słów zamienionych na synonimy | 17% |
Dwa wyniki dla 400 tokenów (95% i 92%) pochodzą z różnych zestawów testowych i OpenAI ich nie łączy. Prościej: zamień co czwarte słowo na synonim, a detektor znajdzie znak w jednym tekście na sześć. Anthropic liczb nie podaje, pisze tylko, że lekka edycja raczej nie usunie znaku całkowicie, a przepisanie każdego słowa go usunie.
Niezależne testy dotyczą otwartej implementacji SynthID-Text na mniejszych modelach, bo do Gemini i Claude’a nikt z zewnątrz nie ma detektora:
- Zespół z ETH Zurych (grudzień 2024 r.) pokazał, że gotowy model do parafrazowania usuwał znak z ponad 90% tekstów o długości ok. 1000 tokenów. Autorzy oceniają, że SynthID-Text łatwiej wyczyścić niż inne nowoczesne metody znakowania.
- Han i in. (TrustCom 2025, teksty po 200 tokenów) najgorszy wynik dostali przy tłumaczeniu na chiński i z powrotem: znak wykryto w 67,5% tekstów, a 22,5% tekstów bez znaku dostało fałszywy alarm. Synonimy szkodziły tej metodzie znacznie mniej.
Liczby OpenAI to dane producenta bez metodyki. 5 października firma opublikowała raport techniczny textGrain, ale to wyłącznie matematyka metody, bez żadnego eksperymentu, więc nadal nie wiadomo, skąd wzięły się wyniki z tabeli.
Nawet 1% fałszywych alarmów to wynik obliczenia, a nie pomiaru. Raport sam zastrzega, że wyliczenie w idealnych założeniach nie gwarantuje tego samego poziomu błędu dla każdego klucza i zastosowania. A jeśli 1% się utrzyma, na 10 000 tekstów napisanych przez ludzi wypada ok. 100 fałszywych trafień.
Testy edycji są tylko po angielsku. Jak znak znosi redakcję polskiego tekstu, nikt nie pokazał.
Znak dobrze działa na długim tekście, którego nikt nie ruszał. Każda redakcja, tłumaczenie albo parafraza go osłabia, a w tekście po porządnej redakcji może go praktycznie nie być.
Polski tekst: pierwsze dane
Kiedy 6 października nagrywałem Shorta o znaku wodnym w ChatGPT, na planszy o polskim napisałem „brak danych”, bo testy w ogłoszeniu OpenAI dotyczyły angielskiego. Dane są jednak w centrum pomocy OpenAI, zaktualizowanym ok. 12 października: to wykres wykrywalności znaku dla 24 języków urzędowych UE. OpenAI przetłumaczyło 500 syntetycznych poleceń z angielskiego na 23 pozostałe języki i mierzyło wykrywalność przy 1% fałszywych alarmów. Dla języków z wynikiem poniżej 60% zwiększyło siłę znaku regulowanym parametrem, który samo nazywa „pokrętłem”.
W tekście OpenAI podaje tylko dwie skrajne liczby: najlepszy hiszpański (69,0%) i najsłabszy rumuński (42,2%). Wartości dla polskiego odczytałem z wykresu, mierząc wysokość słupków w pikselach. Skalę sprawdziłem na obu liczbach podanych przez OpenAI: mój odczyt dał 68,9% i 42,1%, więc błąd mieści się w ok. 1 punkcie procentowym.
| Język | Wykrywalność bazowa | Po wzmocnieniu sygnału |
|---|---|---|
| hiszpański (najlepszy) | 69,0% | bez zmian |
| angielski | ok. 68% | bez zmian |
| niemiecki | ok. 61% | bez zmian |
| czeski | ok. 60% | bez zmian |
| polski | ok. 55% | ok. 64% |
| słowacki | ok. 55% | ok. 63% |
| rumuński (najsłabszy) | 42,2% | ok. 59% |
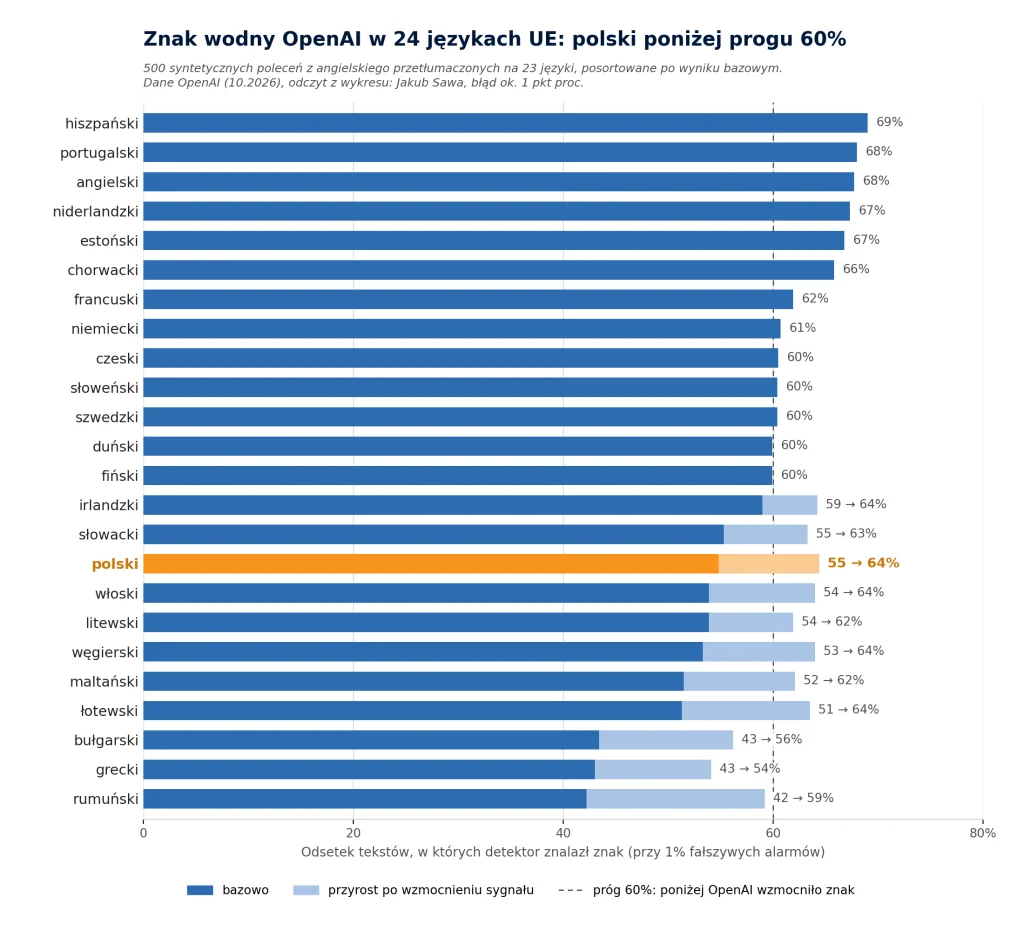
Dane OpenAI z centrum pomocy (10.2026), przy 1% fałszywych alarmów. Odczyt z wykresu: Jakub Sawa, błąd ok. 1 pkt proc.
Polski wypada w grupie słabszych języków. Bez wzmocnienia znak znaleziono w ok. 55% polskich tekstów, choć nikt ich nie edytował, a po wzmocnieniu w ok. 64%, wciąż rzadziej niż po angielsku. Tych wyników nie porównuj z 92-95% z testu edycji OpenAI: angielski ma tu ok. 68%, więc test był inny, prawdopodobnie na krótszych tekstach, których długości OpenAI nie podaje. Nie wiadomo też, czy ChatGPT działa z mocniejszym znakiem dla polskiego. OpenAI pisze tylko, że potrafi go wzmocnić i ile to daje. To są dane wyłącznie dla OpenAI: Anthropic i Google nie podają wyników dla poszczególnych języków, a testów edycji polskiego tekstu nie pokazał nikt.
Policzyłem też, ile polskiego tekstu mieści się w progu z kodeksu praktyk. Kodeks zwalnia ze znakowania teksty krótsze niż 200 tokenów, co OpenAI przelicza na ok. 150 słów po angielsku. Polski zużywa więcej tokenów na słowo. Na 48 wpisach z tego bloga (ok. 82 tys. słów, bez bloków kodu) publiczny tokenizer OpenAI o200k_base dał 2,13 tokena na słowo, więc 200 tokenów to ok. 94 polskie słowa, w pojedynczych wpisach od 86 do 104. Na drugim, większym zbiorze polskich artykułów poradnikowych (ok. 255 tys. słów) wynik był ten sam. Krótki akapit, opis produktu albo mail przekraczają ten próg. Tokenizery Claude’a i Gemini są inne, tego nie mierzyłem.
Czego znak nie powie i dlaczego wynik detektora to nie dowód
OpenAI poświęciło temu osobną część ogłoszenia. To pięć zdań, które warto pokazać każdemu, kto chce coś rozstrzygać wynikiem detektora:
- „Znak wodny nie mierzy ludzkiego wkładu.”
- „Znak wodny nie rozstrzyga o prawach do tekstu ani o odpowiedzialności za niego.”
- „Znak wodny nie identyfikuje użytkownika.”
- „Znak wodny nie potwierdza prawdziwości treści.”
- „Brak wykrytego znaku wodnego nie dowodzi autorstwa człowieka.”
Błąd działa w obie strony. Tekst z AI może nie mieć znaku, bo jest krótki, zredagowany, przetłumaczony albo pochodzi z modelu, który nie znakuje. Tekst człowieka może znak mieć, jeśli Claude go streścił albo przetłumaczył. Przy samej korekcie znaku zwykle prawie nie ma, bo Claude zmienia mało słów. Anthropic dodaje, że znak nie odróżni tekstu napisanego przez Claude’a od tekstu, który Claude mocno zredagował.
Popularne detektory AI działają zupełnie inaczej: nie mają klucza żadnego dostawcy, więc zgadują po wzorcach w tekście, np. po doborze słów. Jak to wygląda w praktyce, widziałem u klienta. Sprawdził popularnym detektorem swój własny tekst z 2018 r. i dostał wynik: w większości napisany przez AI. ChatGPT miał premierę 30 listopada 2022 r.
Ostrożni są też sami dostawcy: OpenAI nie udostępnia detektora publicznie właśnie z powodu ryzyka przeoczeń i fałszywych alarmów. Wykryty znak to poszlaka, że model konkretnego dostawcy brał udział w powstaniu tekstu, nic więcej. Detektor stylu nie mówi nawet tego. Wynik żadnego detektora nie jest więc dowodem, kto napisał tekst, i nie powinien rozstrzygać sporu z copywriterem, pracownikiem czy studentem.
Wątek OpenAI i przykład klienta streściłem w półtoraminutowym Shorcie. Jedna poprawka do filmu: plansza „Polski: brak danych” jest nieaktualna, bo OpenAI pokazało już wynik dla polskiego (ok. 55%, po wzmocnieniu sygnału ok. 64%).
Gdzie prawo i dostawcy się rozjeżdżają
W trzech miejscach wybory dostawców mijają się z przepisami albo z kodeksem praktyk i każde z nich ma praktyczne skutki.
Tłumaczenia: wytyczne zwalniają, Claude znakuje
Wytyczne Komisji do art. 50 z 20 lipca 2026 r. (pkt 92) wymieniają tłumaczenia tekstu zrobione przez AI wśród przykładów standardowej edycji, której nie trzeba znakować. Anthropic znakuje je mimo to, bo w tłumaczeniu każde słowo wybiera Claude. OpenAI nie pisze, jak traktuje tłumaczenia z ChatGPT. Jeśli więc tłumaczysz Claude’em polską ofertę dla klienta z zagranicy, angielska wersja niesie znak, choć prawo tego nie wymaga, a treść jest Twoja.
Zasięg i API: prawo celuje w systemy, nie w modele
Art. 50 dotyczy systemów AI, a nie modeli. Wytyczne (pkt 27) zachęcają dostawców modeli do znakowania na poziomie modelu, właśnie po to, żeby ułatwić zadanie firmom, które budują na nich własne systemy. Anthropic tak zrobił, więc znak trafia do każdego tekstu z obsługiwanych modeli Claude’a. OpenAI w API zostawia decyzję klientom, żeby, jak pisze, sami zdecydowali, jak wykorzystać znaki wodne do realizacji swoich obowiązków. Google o API oficjalnie milczy. Jeśli budujesz na API własne narzędzie, które generuje teksty, obowiązek z ust. 2 może więc spaść na Ciebie.
Detektory: kodeks zakłada dostęp, praktyka jest węższa
Kodeks praktyk pozwala ograniczyć dostęp do detektora znaku w tekście, bo jest mniej wiarygodny niż przy obrazach. Ograniczenie ma być jednak czasowe, a kodeks wymienia, kto ma detektor dostać: organy nadzoru, organy ścigania, media, fact-checkerzy, badacze, organizacje edukacyjne i społeczne. Listę zbliżoną do kodeksu ma tylko Anthropic, OpenAI ogranicza ją do badaczy, a Google nie pokazuje publicznie żadnej drogi do sprawdzenia tekstu. Część z tego może się zmienić do 2 grudnia, a do 2 lutego 2027 r. sygnatariusze kodeksu mają zapewnić współdziałanie swoich detektorów. Na dziś znak, który z założenia ma być czytelny dla maszyn, sprawdzi wąskie grono, a zwykła firma, szkoła czy klient nie sprawdzą go wcale.
Co to znaczy dla Ciebie
Znakowanie to obowiązek dostawców, ale kilka decyzji zostaje po Twojej stronie. To nie jest porada prawna: przy własnym przypadku zapytaj prawnika.
Wydajesz serwis: kiedy tekst z AI trzeba oznaczyć
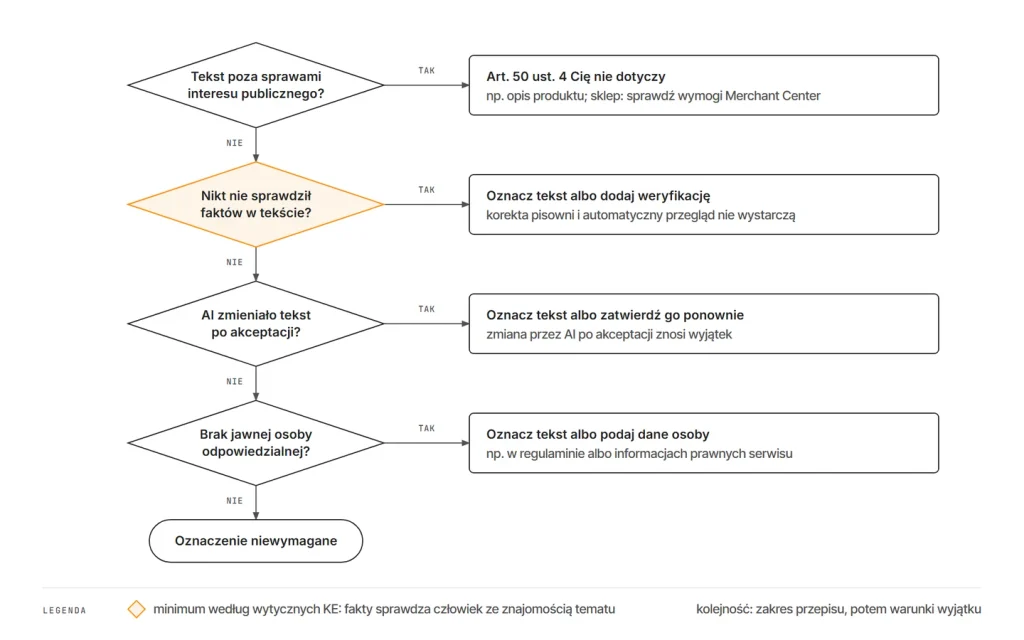
Checklista do art. 50 ust. 4 AI Act na podstawie wytycznych Komisji Europejskiej (pkt 134-138). To nie jest porada prawna.
Obowiązek z art. 50 ust. 4 dotyczy tekstów publikowanych po to, żeby informować o sprawach interesu publicznego, i działa od 2 sierpnia 2026 r., bez okresu przejściowego. Wytyczne Komisji pokazują zakres na przykładach: obejmuje m.in. streszczenie artykułu o decyzji rady miasta i fragmenty artykułu lifestylowego o wpływie diet na chorobę.
Oznaczać nie musisz, jeśli tekst przeszedł weryfikację człowieka lub kontrolę redakcyjną i ktoś ponosi za niego odpowiedzialność redakcyjną. Według wytycznych treść musi sprawdzić człowiek ze znajomością tematu, a sprawdzenie faktów to minimum. Nie wystarczy korekta pisowni, sama polityka redakcyjna ani automatyczny przegląd, a zmiana tekstu przez AI po akceptacji znosi wyjątek. Dane osoby odpowiedzialnej redakcyjnie mają być publicznie dostępne, np. w regulaminie serwisu.
Jeśli warunków wyjątku nie spełniasz, kodeks praktyk każe dać oznaczenie nad tekstem, przy tytule albo w metryczce na początku i pozwala oznaczyć tylko fragment z AI. Tekst wygenerowany przed 2 sierpnia, ale opublikowany później, też trzeba oznaczyć.
Prowadzisz sklep: opisy produktów i Merchant Center
Opisy produktów i reklamy są poza art. 50 ust. 4, o ile nie zawierają twierdzeń o zdrowiu, bezpieczeństwie albo ekologii. Google Merchant Center wymaga jednak, żeby tytuły i opisy wygenerowane przez AI trafiały do atrybutów structured_title i structured_description z wartością trained_algorithmic_media, a obrazy z AI miały metadane IPTC DigitalSourceType. To deklaracja, którą sklep składa sam w danych produktowych, i dziś jest bardziej namacalnym obowiązkiem niż art. 50.
SEO: Google nie wspomina o znakach wodnych
Wytyczne Google dotyczące treści z generatywnej AI nie mówią o znakach wodnych w tekście ani słowa. Mówią, że informacja o tym, jak powstała treść, pomaga czytelnikom zrozumieć kontekst, i ostrzegają, że masowe generowanie stron bez wartości dla użytkownika może naruszać zasady dotyczące spamu. O pozycji decyduje to, czy tekst wnosi coś nowego. Znak wodny w tych wytycznych się nie pojawia.
Budujesz narzędzie na API: możesz być dostawcą
Claude znakuje teksty z obsługiwanych modeli zawsze, także w API. W API OpenAI znak jest domyślnie wyłączony i włącza się go w Ustawieniach organizacji (Kontrola danych, Pochodzenie tekstu) albo projektu. Przy API Gemini oficjalnej informacji brak.
Jeśli zbudowałeś na API system, który generuje teksty, np. generator opisów dla klientów albo chatbota, możesz być dostawcą systemu AI w rozumieniu art. 50 ust. 2. Wtedy znakowanie jest Twoim obowiązkiem: dla nowych systemów od 2 sierpnia 2026 r., dla działających wcześniej od 2 grudnia. Anthropic pisze wprost, że jeśli wdrażasz Claude’a we własnym produkcie, sam musisz ocenić, czego wymaga od Ciebie art. 50.
Umowy z klientami i ocena ludzi
Tekst przetłumaczony przez Claude’a niesie znak, nawet jeśli treść jest Twoja. Jeśli umowa z klientem mówi coś o używaniu AI, ustal zasady wprost, zamiast zakładać, że nikt tego nie sprawdzi. Przy ocenie copywriterów i pracowników wpisz zasady używania AI do umowy i proś o historię wersji, a nie o wynik z detektora.
Twoja kolej
Od sierpnia 2026 r. tekst z Claude’a, z ChatGPT w UE i z aplikacji Gemini niesie niewidoczny znak wodny. To kruchy sygnał dla wąskiego grona sprawdzających, a nie test autorstwa. Ważniejsze od samego znaku jest to, które narzędzia w Twoim procesie znakują teksty, czy budując coś na API, nie stajesz się dostawcą systemu AI, i czy Twoja redakcja spełnia warunki wyjątku z art. 50 ust. 4.
Wiesz, przez które modele przechodzą teksty w Twoim serwisie, zanim trafią do CMS-a? Jeśli chcesz to uporządkować razem z wpływem na SEO i widoczność w AI, umów konsultację.
Zastrzeżenia do danych: wartości dla polskiego to mój odczyt z wykresu OpenAI z błędem ok. 1 punktu procentowego i dotyczą tylko metody textGrain. Pomiar tokenów zrobiłem publicznym tokenizerem OpenAI, inni dostawcy tną tekst inaczej. Wszystkie informacje są aktualne na 19 października 2026 r., a dostawcy zmieniają zasady co kilka tygodni.
Źródła
Wszystkie sprawdzone 19 października 2026 r.
- Rozporządzenie (UE) 2024/1689 (AI Act), Dz.U. L z 12.07.2024: EUR-Lex
- Rozporządzenie (UE) 2026/1744 (omnibus cyfrowy dla AI), Dz.U. L z 24.07.2026: EUR-Lex
- Komisja Europejska, kodeks praktyk dotyczący przejrzystości treści generowanych przez AI, wersja końcowa z 10.06.2026: strona kodeksu
- Komisja Europejska, wytyczne do art. 50 AI Act, C(2026) 5054, 20.07.2026: strona wytycznych
- Ustawa z 3 lipca 2026 r. o systemach sztucznej inteligencji, Dz.U. 2026 poz. 1003: Dziennik Ustaw
- Anthropic, „How Claude’s text watermark works”, 14.08.2026 (aktualizacja 1.09.2026): anthropic.com
- Anthropic, „How Claude marks AI-generated content”, centrum pomocy: support.claude.com
- OpenAI, „Nasze podejście do unijnych zasad dotyczących pochodzenia tekstu”, 5.10.2026: openai.com
- OpenAI, „textGrain: Entropy-Calibrated Watermarking for Language Model Text”, raport techniczny, 5.10.2026: PDF
- OpenAI, „Sygnały pochodzenia w treściach generowanych przez OpenAI”, centrum pomocy: help.openai.com
- Dathathri i in., „Scalable watermarking for identifying large language model outputs”, Nature 634, 23.10.2024: nature.com
- Google DeepMind, „Watermarking AI-generated text and video with SynthID”, 14.05.2024: deepmind.google
- Google, SynthID Detector dla wszystkich, 7.10.2026: blog.google
- Google, podpisanie kodeksu praktyk, 24.07.2026: blog.google
- Forum Gemini API, wątek o SynthID w tekście z API, 5-19.08.2026: discuss.ai.google.dev
- Jovanović, Gloaguen, Vechev (ETH Zurych), „Probing Google DeepMind’s SynthID-Text Watermark”, 20.12.2024: sri.inf.ethz.ch
- Han, Li, Ni, Zulkernine, „Robustness Assessment and Enhancement of Text Watermarking for Google’s SynthID”, TrustCom 2025: arXiv 2508.20228
- Nemecek, Chaudhary, Ayday, „Watermarks Without Verification: AI Text Watermarking After the EU AI Act”, 9.09.2026: arXiv 2609.09604
- Google Search Central, wytyczne dotyczące treści z generatywnej AI: developers.google.com
- Google Merchant Center, treści wygenerowane przez AI: support.google.com
- Pomiar własny: tokenizer o200k_base (tiktoken 0.14.0) na 48 wpisach z jakubsawa.pl (ok. 82 tys. słów) i na drugim zbiorze polskich artykułów (ok. 255 tys. słów); odczyt wykresu językowego OpenAI z kalibracją na wartościach podanych przez OpenAI.